


2026.05.23

カテゴリ: カテゴリ未分類
Standardized Mean Differenceの略でして、日本語に訳すと「参加者(ケース)間標準化平均値差」といったところです。

わたしはコチラを使って修士論文を書いたので以下に
私の知っている、ごく初歩的な事を簡単に列挙すると
〇シングルケースデザインで統計処理ができる
◯つまりベースラインと介入がたるABモデルもOK
〇3名~という少数でOK
〇効果量、信頼区間あたりで有意差も言える
というメリットがあります。
最近、単一事例研究でよく見かけるTau-Uは効果量だけですからエビデンスに訴えかけるにはBC-SMDは有効と言えるでしょう。
コチラの書籍の方が詳しく記載されています。

作業療法士のための 超実践!シングルケースデザイン 導入から統計手法まで すぐに使えるExcel・Rのサンプルデータ付き [ 丁子雄希 ]
しかし、こちらを確認してもBC-SMDはやや複雑で、わからなかったことが多々あります。
例えばですが、細かな設定方法についてです。
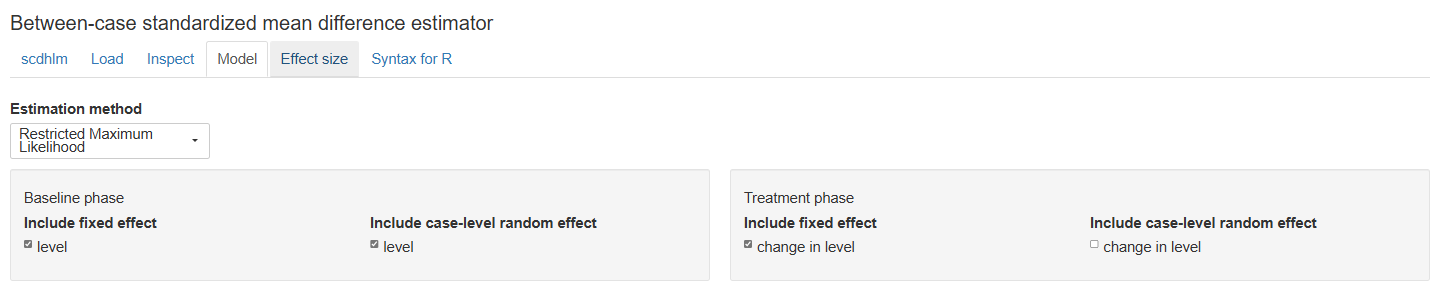
[model]タブの設定ですが、きっとこの記事には
線形階層モデル(HLM)を用いたい
という方がたどり着いているはずなので、
REMLを用いたいということでしょう。
Moment Estimationでは、
HLMは用いていないという事でしたので
こちらの画面のベースラインの固定効果、ランダム効果
については上記書籍にも参考文献にも丁寧に書いてありました。
参考文献はコチラです。https://doi.org/10.4037/cmdp.2016.1
https://onlinelibrary.wiley.com/doi/10.4073/cmdp.2016.1
〇ベースラインについてはデフォルトの設定でどちらもチェックが必須☑☑⇒つけないとエラー表示あり
〇介入期のランダム効果はケース数が少ない場合はチェックなしにしましょう□
〇また「治療効果がケース間で一定」という仮定で行う場合、介入期のランダム効果はチェックなし□⇒チェックをいれると保守的(そりゃケースごとに違うでしょう。的)に効果量の値は小さくなります。
つまり、まずは3例から解析したいという方は、☑☑☑□が適切のようでした。
そして、更に分かりにくいのがこの下のMA1やらAR1やら。
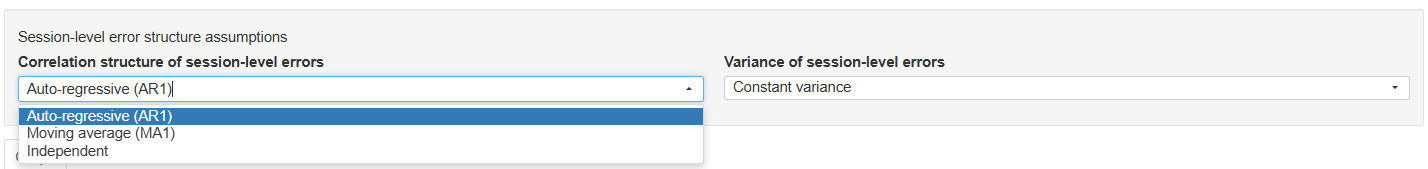
改めて説明を聞いても私には理解できない部分もあったのですが、
以下のようなコードをRで計算することで判定できました。
また、こちらは「ABABdata」というエクセルファイルに、データが入っている場合に動くように書かれています。
つまり、あなたが
「Aさんのデータ.xlsx」というエクセルファイルを読み込みたい場合は、このコードのなかにある「ABABdata.xlsx」の部分を「Aさんのデータ.xlsx」に書き換えてください。
#########################################
#ABABデザイン:誤差構造 × 分散構造最適判定コード#
#########################################library(nlme)
library(openxlsx)# --- 1. データ読み込み ---dat=0
dat <- read.xlsx("ABABdata.xlsx", sheet = 1)# --- 2. ACF / PACF(目視チェック) ---cases <- unique(dat$case)par(mfrow = c(2, length(cases)))for (i in seq_along(cases)) {y <- dat$outcome[dat$case == cases[i]]acf(y, main = paste("ACF:", cases[i]))pacf(y, main = paste("PACF:", cases[i]))}# --- 3. 6モデルをフィットしてAIC比較 ---select_best_of_6 <- function(dat) {fm_ind_const <- lme(outcome ~ 1 + trt, random = ~1|case,data = dat, control = lmeControl(returnObject=TRUE))fm_ind_var <- lme(outcome ~ 1 + trt, random = ~1|case,weights = varIdent(form=~1|phase),data = dat, control = lmeControl(returnObject=TRUE))fm_ar1_const <- lme(outcome ~ 1 + trt, random = ~1|case,correlation = corAR1(0.01, ~session|case),data = dat, control = lmeControl(returnObject=TRUE))fm_ar1_var <- lme(outcome ~ 1 + trt, random = ~1|case,correlation = corAR1(0.01, ~session|case),weights = varIdent(form=~1|phase),data = dat, control = lmeControl(returnObject=TRUE))fm_ma1_const <- lme(outcome ~ 1 + trt, random = ~1|case,correlation = corARMA(0, ~session|case, p=0, q=1),data = dat, control = lmeControl(returnObject=TRUE))fm_ma1_var <- lme(outcome ~ 1 + trt, random = ~1|case,correlation = corARMA(0, ~session|case, p=0, q=1),weights = varIdent(form=~1|phase),data = dat, control = lmeControl(returnObject=TRUE))# AIC表aic_tbl <- AIC(fm_ind_const, fm_ind_var,fm_ar1_const, fm_ar1_var,fm_ma1_const, fm_ma1_var)# 最適モデルbest_model <- rownames(aic_tbl)[which.min(aic_tbl$AIC)]# 読みやすい名前readable <- c(fm_ind_const = "independent + constant variance",fm_ind_var = "independent + phase variance",fm_ar1_const = "AR1 + constant variance",fm_ar1_var = "AR1 + phase variance",fm_ma1_const = "MA1 + constant variance",fm_ma1_var = "MA1 + phase variance")# --- 〇×判定表 ---model_names <- names(readable)flag <- ifelse(model_names == best_model, "〇", "×")flag_table <- data.frame(Model = readable,Selected = flag)list(AIC_table = aic_tbl,best_model_code = best_model,best_model_label = readable[best_model],flag_table = flag_table)}# --- 4. 実行 ---result6 <- select_best_of_6(dat)# --- 5. 出力 ---cat("\n--- AIC table ---\n")print(result6$AIC_table)cat("\n--- 〇× 判定表 ---\n")print(result6$flag_table)cat("\n最適モデル(コード名):", result6$best_model_code, "\n")cat("最適モデル(読みやすい名前):", result6$best_model_label, "\n")
以上です。
どうやら自己相関あたりをみているそうです。
目視的に判定もできるようですのでACFとPACFについては
グラフを確認できるようにもしました。
論文などで用いる場合は、グラフもしっかり目視で確認してください。
ちなみに判定基準はこちらです。
◯モデルの判定基準
# ACFがlag1から徐々に減衰 & PACFがlag1だけ強い → AR(1)
# ACFがlag1だけ突出 & PACFが徐々に減衰 → MA(1)
# ACFもPACFもほぼゼロ → independent(誤差は独立)
◯分散差の基準
# p < 0.05 → フェーズごとの分散差が有意 → Variance differs by phase を採用
# p >= 0.05 → 分散差は有意でない → Constant variance を採用
あとは生成AIにコードを直してもらいながら何度も確認をして上記を生成しました。
もし躓いている方がいたときの助けになれば。
また、私が完全に忘れる可能性も考えて。
このとおり、記事を書きましたので
現時点で私の理解が間違っていたら、ごめんなさい。
よければコメントで教えてください。よろしくお願い致します。
お気に入りの記事を「いいね!」で応援しよう


【毎日開催】
15記事にいいね!で1ポイント


© Rakuten Group, Inc.
