Kazu Home Page
2026
2025
2024
2023
2022
2021
2020
2019
2018
2017
2016
2015
2014
2013
2012
2011
2010
2009
2008
2007
2006
2005
2004
1月
2月
3月
4月
5月
6月
7月
8月
9月
10月
11月
12月
全1件 (1件中 1-1件目)
1
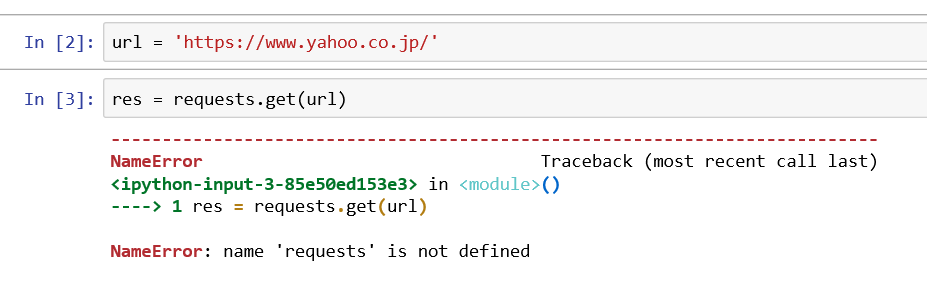
2年前に機械学習を使ってAI競馬予想を行っていましたが、ある時から私のLibreofficeからデータが取得できなくなり、頓挫してしまいました。純粋エクセルが欲しくなりましたが、何か良い方法を考えていました。私の行いたい手順としては下記の通りです。1.netkeibaからレース情報の取得(<-- ここが出来なくなった)2.自分で作った関数で重みづけ(<-- Libreoffice で可能)3.機械学習による競馬予想(<-- Anacondaで可能)という事で情報取得をPythonで動かしたいというのが今回の目的です。調べると、スクレイピングという言葉が出てきました。このページがヤフーをスクレイピングしていたのでとっつきやすいと思い手を付けました。たった2行で取得できるのか?と思い早速入力してみました。url = 'https://www.yahoo.co.jp/'res = requests.get(url)res.text[:500]上記のようにさっそくエラーがでました。もう少し読むと、requestsを入れるにはインストールやインポートが必要になります。詳しい説明は、「図解!Beautiful SoupでWEBスクレイピング徹底解説!」を参照ください。と書いてあります。やり方は、自分はAnaconda3を使っているので、promptを選択してから。conda install requestsを入力するようです。良し出来たと思い、先ほどのコマンド実行前に下記のコマンドを入力して#requests をインポートします。(Web scrapingには必須)import requests再度実行すると。resまではゲットできたようですが、表示させようとしたresponseで再度エラー、躓きました。どうやら、responsesもインストールかと思いましたが、resにinputしたので、resを出力しないと行けなかったです。yahooは表示できましたが、netkeibaは文字化けしているようです。再度ぐぐっていると。encodeが出来るとのこと。下記コマンドを実行です。res.encoding = res.apparent_encodingそうすると、表示してくれました。HTMLがそのまま出ているようです。とりあえずスクレイピングは出来た模様です。次回はこれをテキストに出力、取り込みたいフォーマットに変換するところをまで行いたいです。今日のプログラムです。簡単に取得できるものですね。#requests をインポートします。(Web scrapingには必須)import requests#urlを取得 url = 'https://race.netkeiba.com/race/shutuba_past.html?race_id=202004020211&rf=shutuba_submenu'#resに内容を代入res = requests.get(url)#resをencodeして文字化け回避res.encoding = res.apparent_encoding#画面出力print(res.text)文字化け対策には別のコマンドもあるようです。上記でダメな場合は使ってみても良いと思います。#BeautifulSoup は文字化け対策from bs4 import BeautifulSoupres.encoding = 'shift_jis'soup =BeautifulSoup(res.text , 'html.parser')
Jul 22, 2020
コメント(2)