2020年08月の記事
全3件 (3件中 1-3件目)
1
-
Python で 競馬予想 第4回(Pyhton上での配列定義)
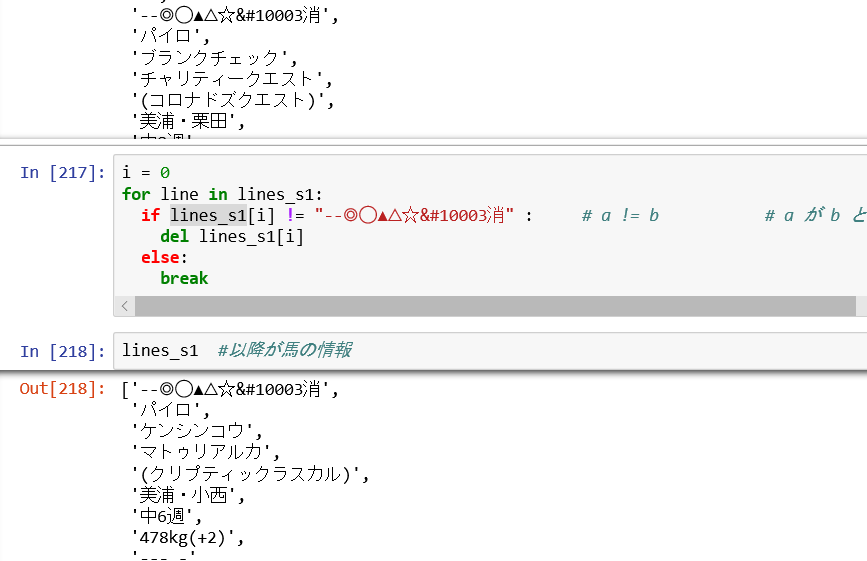
pythonで競馬予想。これまでのバッグナンバーは下記です。今回は配列にチャレンジです。Python で 競馬予想 第1回(データ取得編 scraping スクレイピング)Python で 競馬予想 第2回(HTML解析編)Python で 競馬予想 第3回(Python上でのデータ加工) Python で 競馬予想 第4回(Python上での配列定義) --- 今回はここ。前回までで馬柱を抜き出す前段階まで到達しました。(下記のような感じです。)ただ、まだこのままですと、メモ帳に書いてあるのと変わらないので、これを必要な配列に入れていく作業を今回はしたいと思います。まずは配列の定義です。DataFrameでも出来るのかもしれないですが、いろいろと調べるとリストの方が扱いやすそうだったので、リストで配列を定義しました。定義の仕方もいろいろありますが、箱を作るという事だけに専念するのであれば、今回の方法が一番良いと思います。コマンドは結構特殊です。次にWEBデータを箱に詰めていきます。休養している馬もいるのでその場合は飛ばす処理を追加しています。出来上がった基本出走馬情報です。この中で私が使う情報は馬名、休養何週、鞍上、斤量のみなので、それだけ抜き出しました。きれいに並んだと思います。次に前5走情報を処理します。詳しいことは割愛しますが、Find関数は便利に使えます。これを使えば文字サーチできて、その場所を返すので非常に有用です。最初の馬の前走と最後の馬の5走前の情報が見事表示できました。レース場所、レース名、芝orダート、距離、走破タイム、馬場状態、頭数、鞍上、斤量、位置、上がり3Fデータを予想に使います。次は機械学習するために数値化するための前処理をしたいと考えています。今日のリスト#馬柱情報を入力するリストを作成する。# BASIC_INFORMATON[Race_horse_num,i] ... 基本情報# 予想印,父、馬名、母、母の父、所属・厩舎、休養何週、馬体重、オッズ、人気順、馬齢、鞍上、斤量# 0 1 2 3 4 5 6 7 8 9 10 11 12 13# Race_INFORMATON[Race_horse_num,i,j] j --- x走前のレース情報# 1走前 日付場所、着順、レース名、グレード、芝ダ距離・タイム・馬場状態、頭数・枠・人気・鞍上・斤量、位置・上がり・馬体重、1着馬・着差# 0 1 2 3 4 5 6 7 # :# 5走前 日付場所、着順、レース名、グレード、芝ダ距離・タイム・馬場状態、頭数・枠・人気・鞍上・斤量、位置・上がり・馬体重、1着馬・着差# 0 1 2 3 4 5 6 7 #2次元、3次元配列宣言BASIC_INFORMATION = [[0 for i in range(13)] for j in range(Race_horse_num)]Race_INFORMATION = [[[0 for i in range(7)] for j in range(5)] for k in range(Race_horse_num)]#すべて情報には”0”を代入している。リストの最大の個所が使えるかを閣員print(BASIC_INFORMATION[Race_horse_num-1][12],Race_INFORMATION[Race_horse_num-1][4][6])#WEBデータをリストに詰める作業を開始。休養だった場合は次のレースへ移動する。line_count = 0lines_s2=lines_s1for i in range(Race_horse_num): for j in range(13) : str =lines_s2[line_count] BASIC_INFORMATION[i][j]=str line_count +=1 for j in range(5) : for k in range(7) : break_flag = lines_s2[line_count].find('休養') if break_flag != -1 : #休養だった場合、次のレースへ移動 Race_INFORMATION[i][j][k]=lines_s2[line_count] line_count +=1 k = 8 break else : skip_flag_1 = lines_s2[line_count].find('芝') skip_flag_2 = lines_s2[line_count].find('ダ') skip_flag_3 = (k == 2) if (skip_flag_1 != -1 or skip_flag_2 !=-1) and (skip_flag_3 != 0) : k=k+1 line_count -=1 Race_INFORMATION[i][j][k]=lines_s2[line_count] line_count +=1 for l in range(3): if lines_s2[line_count].isdigit() : #半角整数はTrue line_count +=1 else: l = 300 break line_count#基本情報を必要な個所だけ抜き出す。BASIC_INFORMATION_2 = [[0 for i in range(4)] for j in range(Race_horse_num)]for i in range(Race_horse_num): BASIC_INFORMATION_2[i][0]=BASIC_INFORMATION[i][2] #馬名 BASIC_INFORMATION_2[i][1]=BASIC_INFORMATION[i][6] #休養何週? BASIC_INFORMATION_2[i][2]=BASIC_INFORMATION[i][11] #鞍上 BASIC_INFORMATION_2[i][3]=BASIC_INFORMATION[i][12] #斤量BASIC_INFORMATION_2#近5走の情報の表示で必要な情報をコピー# Race_INFORMATON[Race_horse_num,i,j] j --- x走前# 1走前 日付場所、レース名、グレード、芝ダ距離・タイム・馬場状態、頭数・枠・人気・鞍上・斤量、位置・上がり・馬体重、1着馬・着差# 0 1 2 3 4 5 6 7 8 9 10 # [0] [1] [2] [3] [4] [5] [6] [7]RACE_INFORMATION_2 = [[[0 for i in range(11)] for j in range(5)] for k in range(Race_horse_num)]for i in range(Race_horse_num): for j in range(5) : RACE_INFORMATION_2[i][j][0]=Race_INFORMATION[i][j][0] #場所 RACE_INFORMATION_2[i][j][1]=Race_INFORMATION[i][j][1] #Race名 RACE_INFORMATION_2[i][j][2]=Race_INFORMATION[i][j][3] #芝 or ダ RACE_INFORMATION_2[i][j][3]=Race_INFORMATION[i][j][3] #距離 RACE_INFORMATION_2[i][j][4]=Race_INFORMATION[i][j][3] #タイム RACE_INFORMATION_2[i][j][5]=Race_INFORMATION[i][j][3] #馬場状態 RACE_INFORMATION_2[i][j][6]=Race_INFORMATION[i][j][4] #頭数 RACE_INFORMATION_2[i][j][7]=Race_INFORMATION[i][j][4] #鞍上 RACE_INFORMATION_2[i][j][8]=Race_INFORMATION[i][j][4] #斤量 RACE_INFORMATION_2[i][j][9]=Race_INFORMATION[i][j][5] #位置取り RACE_INFORMATION_2[i][j][10]=Race_INFORMATION[i][j][5] #上がり RACE_INFORMATION_2#文字の場所指定をすれば、MID$のような使い方が出来る。# RACE_INFORMATION_2[i][j][0][11]#find関数は文字がある場所を返す。ない場合は"-1"となる。fd = RACE_INFORMATION_2[i][j][0].find('\xa0')print (RACE_INFORMATION_2[i][j][0][11],':',fd,':',RACE_INFORMATION_2[i][j][0][fd+1])for i in range(Race_horse_num): for j in range(5) : fd = RACE_INFORMATION_2[i][j][0].find('\xa0') if fd != -1 : RACE_INFORMATION_2[i][j][0]=RACE_INFORMATION_2[i][j][0][fd+1] #場所 RACE_INFORMATION_2[i][j][1]=RACE_INFORMATION_2[i][j][1] #Race名 if RACE_INFORMATION_2[i][j][2] != 0 : fd = RACE_INFORMATION_2[i][j][2].find('芝') if fd != -1 : RACE_INFORMATION_2[i][j][2]="芝" #芝 or ダ RACE_INFORMATION_2[i][j][3]=RACE_INFORMATION_2[i][j][3][fd+1:fd+5] #距離 fd = RACE_INFORMATION_2[i][j][4].find(':') if fd != -1 : RACE_INFORMATION_2[i][j][4]=RACE_INFORMATION_2[i][j][4][fd-1:fd+5] #タイム length =len(RACE_INFORMATION_2[i][j][5]) RACE_INFORMATION_2[i][j][5]=RACE_INFORMATION_2[i][j][5][length-1] fd = RACE_INFORMATION_2[i][j][2].find('ダ') if fd != -1 : RACE_INFORMATION_2[i][j][2]="ダ" #芝 or ダ RACE_INFORMATION_2[i][j][3]=RACE_INFORMATION_2[i][j][3][fd+1:fd+5] #距離 fd = RACE_INFORMATION_2[i][j][4].find(':') if fd != -1 : RACE_INFORMATION_2[i][j][4]=RACE_INFORMATION_2[i][j][4][fd-1:fd+5] #タイム length =len(RACE_INFORMATION_2[i][j][5]) RACE_INFORMATION_2[i][j][5]=RACE_INFORMATION_2[i][j][5][length-1] if RACE_INFORMATION_2[i][j][6] != 0 : fd = RACE_INFORMATION_2[i][j][6].find('頭') if fd != -1 : RACE_INFORMATION_2[i][j][6]=RACE_INFORMATION_2[i][j][6][:fd] #頭数 fd1 = RACE_INFORMATION_2[i][j][7].find('人') fd2 = RACE_INFORMATION_2[i][j][7].find('.') RACE_INFORMATION_2[i][j][7]=RACE_INFORMATION_2[i][j][7][fd1+1:fd2-2] #鞍上 length =len(RACE_INFORMATION_2[i][j][8]) RACE_INFORMATION_2[i][j][8]=RACE_INFORMATION_2[i][j][8][length-4:] #斤量 if RACE_INFORMATION_2[i][j][9] != 0 : fd = RACE_INFORMATION_2[i][j][9].find('\xa0(') if fd != -1 : RACE_INFORMATION_2[i][j][9]=RACE_INFORMATION_2[i][j][9][:fd] #位置取り RACE_INFORMATION_2[i][j][10]=RACE_INFORMATION_2[i][j][10][fd+2:fd+6] #上がり #欲しいところを取り出した情報 最初の馬の、もっとも最近のレースと、最後の馬の最古のレース情報を表示#ずれていないか確認print(RACE_INFORMATION_2[0][0],":",RACE_INFORMATION_2[Race_horse_num-1][4])
Aug 29, 2020
コメント(0)
-

Python で 競馬予想 第3回(Pyhton上でのデータ加工)
これまでの2回でスクレイピングし、HTMLを解析までして、ファイルに出力しようと思いましたが、データが全て1行に書き込まれており頓挫してしまいました。今回はもう少しpython上で所望のデータに変換をしたいと思いトライしています。これまでのバッグナンバーは下記Python で 競馬予想 第1回(データ取得編 scraping スクレイピング)Python で 競馬予想 第2回(HTML解析編)Python で 競馬予想 第3回(Python上でのデータ加工) --- 今回はここ。今回はテキストにしたところから、余計なscriptを省くところからスタートします。参考にしたURLはこちらになります。for script in soup(["script", "style"]): script.decompose()#print(soup).decompose()は、削除のメソッドだそうです。次に前回も行いましたが、テキストを取得します。text=soup.get_text()#print(text)前回と同じように改行がいっぱいできてしまいます。今回違うのはこれからです。テキストを改行ごとにリストに入れて、リスト内の要素前後の空白を除去します。lines= [line.strip() for line in text.splitlines()]# textを改行ごとにリストに入れて、リスト内の要素の前後の空白を削除これを行うことで1次配列の中にすべて入って作業がやりやすくなりました。次に余計な空白行の除去に取り組みます。関数を使うのはお手の物なので、行が何も入っていなかったら削除して、関数を詰めます。i = 0for line in lines: if lines[i]=="" : del lines[i] # print (i) else: print(lines[i]) i += 1そうすると、何も書いていない行が省かれます。次にリストをコピーしてデータを眺めるとレース名は"11R"が2回出てきたところにあるので、そこまではデータを削除します。lines_s0 = linesi = 0j = 0for line in lines_s0: if lines_s0[i] != "11R" : # a != b # a が b と異なる del lines_s0[i] else: j += 1 i += 1 if j == 2: # 2回目の11Rで抜ける 2回目の11Rの次がレース名 print("11R 2times out loop") break else : print(lines_s0[i],j)lines_s0[2] # レース名が表示されればOK見事レース名が表示されました。次に馬柱の前には必ず'--◎◯▲△☆✓消'が入りそうなので、そこまでのデータは消します。i = 0for line in lines_s1: if lines_s1[i] != "--◎◯▲△☆✓消" : # a != b # a が b と異なる del lines_s1[i] else: breaklines_s1 #以降が馬の情報見事、馬柱から必要なデータを確保できそうです。次に馬ごとに分けなければなりませんが、疲れたので今日はこの辺りで。今日の一覧soup =BeautifulSoup(res.text , 'html.parser')for script in soup(["script", "style"]): script.decompose()#print(soup)text=soup.get_text()#print(text)lines= [line.strip() for line in text.splitlines()]# textを改行ごとにリストに入れて、リスト内の要素の前後の空白を削除i = 0for line in lines: if lines[i]=="" : del lines[i] # print (i) else: print(lines[i]) i += 1i = 0j = 0for line in lines_s0: if lines_s0[i] != "11R" : # a != b # a が b と異なる del lines_s0[i] else: j += 1 i += 1 if j == 2: # 2回目の11Rで抜ける 2回目の11Rの次がレース名 print("11R 2times out loop") break else : print(lines_s0[i],j)i = 0for line in lines_s1: if lines_s1[i] != "--◎◯▲△☆✓消" : # a != b # a が b と異なる del lines_s1[i] else: break
Aug 9, 2020
コメント(2)
-
Python で 競馬予想 第2回(HTML解析編)
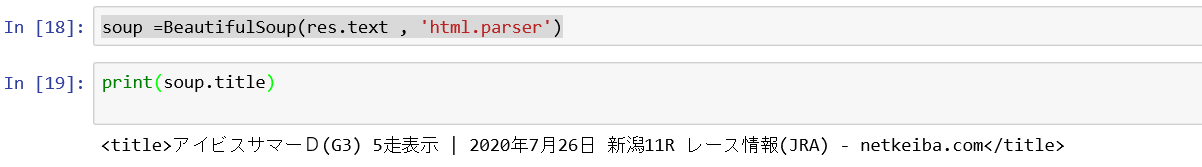
前回WEBデータをスクレイピングするところまでは出来ました。ただ、下記のようにHTMLになっていて、編集するのが大変です。<div class="Data05">芝1200 1:08.5 <strong>稍</strong></div><div class="Data03">16頭 15番 12人 柴田大知 57.0</div><div class="Data06">1-1 (34.5) 498(-2)</div><div class="Data07"><a href="https://db.netkeiba.com/horse/2016104500" target="_blank">ブレイブメジャー</a>(-0.8)</div><a class="movie_202003020311" href="../race/movie.html?race_id=202003020311" style="display: none">HTMLを解析して、テキストを抽出するにはどうしたらよいかと再度ぐぐっていたら、Pythonで取得したWebページのHTMLを解析するはじめの一歩という良いページを見つけました。読んでみると前回最後に紹介した#BeautifulSoupを使うようでした。紹介したWEBページではインストールにはpipを使っていましたが、私はanacondaなのでconda install beautifulsoup4となります。インポートはrequestsをインストールした場所で行います。#requests をインポートします。(Web scrapingには必須)import requests#BeautifulSoup は文字化け対策from bs4 import BeautifulSoup解析を行うにはHTMLからBeautiful Soupオブジェクトを生成します。soup =BeautifulSoup(res.text , 'html.parser')書式は上記のようで、BeautifulSoup(HTML文字列, パーサー)となります。パーサーが良くわからないですが、Pythonに標準で付属している「html.parser」を指定しておくのがベターだと思います。あとは解析したいHTMLを取り出すことが出来ます。soup =BeautifulSoup(res.text , 'html.parser')print(soup.title)見事、アイビスサマーダッシュのタイトルをゲット出来ました。枠情報や前5走の情報を仕入れたいですが、まずはテキストで情報をだすとどのようになるのか調べてみました。for elem in elems: print(soup.getText())空白がかなり多いですが、ボチボチデータになっていそうです。CSVファイルで書き出せば何か編集できる形になりそうなので、出力してみようとすると。f = open('out.csv', 'w')data =soup.getText()writer = csv.writer(f)writer.writerow(data)f.close()書き出そうとしたところでエラーが出ました。CP932は変換できないと。またまた、ぐぐらなければなりません。早速CP932でぐぐると簡単にみつかりました。(リンクはここ)日本語OSや特殊OSの文字コードがPyhtonでは変換できないと書いてあります。中身を読むと、表現できない字は無視する便利なコマンドがあるようです。# CP932 で表現できない文字は無視するf = open('all_names.csv', 'w', encoding='CP932', errors='ignore') 早速適応してみましょう変換は出来た模様です。ちょっと出力された文字にまた、HTMLが入ってきているのが不安なのですが、とりあえずファイルに出力してみることにしました。writer = csv.writer(f)writer.writerow(data)f.close()出来上がったフィルは、、、インポートしようとすると文字化けおよび、1行にすべて書かれているようでダメなようです。別な手法を探さなければなりません。
Aug 9, 2020
コメント(0)
全3件 (3件中 1-3件目)
1