


PR
令和維新
2004年4月から企業を離れ、コンサルタントや情報起業を試行しなが ら、失われた20年を取り戻し、日本再生をめざす私の歩みをみて一人でも多くの後継者が出てくれることを祈りつつ友達から紹 介されたこのホームページの更新を続け、これまでの活動の記録と今やビッグデータ、AI,、IOT,ブロックチェーン、仮想通貨の時代になってしまいましたが、私の現状認識と関連技術を紹介していきたい。
「アメリカは憧れの国ではなくなった」 憧れの国はいずこ?
チューイー: Backed.fundを利用した国債裏付けトークン(Chewy: A Treasury Backed Token using Backed.fund)
チャートの見張りシグナルの罠からの脱出(Escaping the Chart-Watching Signal Trap)
(2)SpaceXは、他のすべてのAI研究所をC言語で打ち負かした。(SpaceXは、他のすべてのAI研究所をC言語で打ち負かした。)
先端技術情報20261108
「競争」と「共存」
ビットコインには何十億ドルも集まっている。では、なぜ高騰しないのか(Bitcoin Is Getting Billions. So Why Isn’t It Pumping?)
クラリテイ法案の解説:上院による歴史的な暗号資産法案の否決の後に何が起きるのか(CLARITY Act Explained: What Happens After the Senate's Rejection of the Landmark Crypto Bill?)
(1)SpaceXは、他のすべてのAI研究所をC言語で打ち負かした。(SpaceXは、他のすべてのAI研究所をC言語で打ち負かした。)
Comments
 New!
藻緯羅さん
源氏物語〔39帖 夕霧…
New!
USM1さん🌹新作「せせらぎ」(… New! 神風スズキさん
春闘のD51、C57 岩…
New!
GKenさん時制の一致をすべき… samito07さん
Category
カテゴリ未分類
(112)連絡
(24)交流会
(27)セミナー
(29)参考情報
(138)オフ会
(36)on-line報告会
(13)翻訳ビジネス
(8)情報開発
(270)ビッグデータ
(90)ブロックチェーン
(258)人工知能
(594)IOT
(310)仮想通貨
(883)コンテンツ
(134)政治経済
(2048)先端技術
(997)DITA
(53)テレワーク
(28)UX
(0)文書管理
(9)テクニカルライテイング
(30)学習
(9)訓練
(1)XMLソリューション
(3)メタバース
(101)Web3
(70)投資
(215)IoT
(35)投資信託
(1)ビットコイン
(850)イーサリアム
(166)NFT
(41)オンライン
(0)受動収入
(14)ソーシャルメデイア
(0)DAO
(2)DeFi
(85)暗号通貨
(168)トークノミクス
(23)アルトコイン
(236)空中投下
(16)スマート契約
(4)ステーブルコイン
(44)金
(5)生成AI
(5)SCM
(4)ウオレット
(9)不労所得
(61)セキュリテイ
(4)ミームコイン
(52)CBDC
(5)PoS
(3)PoW
(1)ETF
(17)仮想通貨ETF
(1)予言
(7)裁定取引
(1)GameFi
(5)マイニング
(11)RWA
(25)DePIN
(22)SWFT
(1)WLFI
(1)アービトラージ
(7)XRP
(69)大統領選
(4)BCH
(1)取引ボット
(17)トレーデイング
(64)不動産
(1)詐欺
(4)貿易戦争
(1)医療
(1)金融
(2)TEZOS
(1)CARDANO
(2)カルダーノ
(3)ステーキング
(8)チェーンリンク
(1)開発
(0)HEDERA
(6)スマートマネー
(0)流動性
(1)AIエージェント
(26)401k
(1)国際送金
(2)solano
(1)AI
(22)暗号資産
(115)機関投資家
(5)量子コンピューター
(8)AIエージェント
(12)ドキュメンテーション
(2)AIトレーデイング
(1)トークン化株式
(2)半導体
(1)フリーランス
(1)AIスキル
(1)Solana
(3)Keyword Search
Freepage List


Shopping List


Aaryan Kakad
アーリアン・カカド
Oct. 24, 2026
2026年10月24日
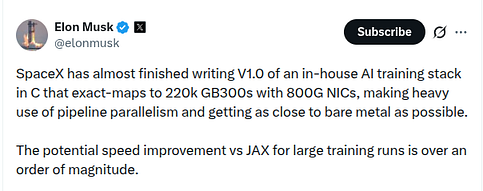
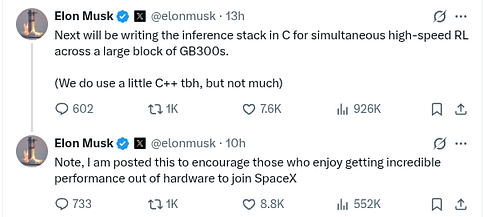
SpaceX just cooked every AI lab.
SpaceXがすべてのAI研究所を圧倒した。
And they did it in C. Not PyTorch. Not JAX. Not CUDA kernels dressed up in Python. Plain C.
しかも、PyTorchでも、JAXでも、Pythonで装飾されたCUDAカーネルでもなく、プレーンなC言語でそれを成し遂げたのだ。
イーロンが昨日これについてのツイートを投稿したものの、ほとんどの人たちはスルーしてしまった。
If you’re an ML person and you understand what’s actually being said — this is one of the most interesting infrastructure moves in AI this year.
もしあなたが機械学習の専門家であり、実際に語られている内容を理解しているなら——これは今年、AI分野における最も興味深いインフラの動きの一つである。
Let me explain it straight in simple words.
分かりやすく直接的に説明しよう。
Every major ML framework you’ve ever used — PyTorch, JAX, TensorFlow — is Python on top of C++/CUDA.
あなたがこれまでに使ったことのある主要なAIフレームワーク(PyTorch、JAX、TensorFlow)はすべて、C++/CUDAの上に構築されたPythonである。
That’s the default. That’s what every lab, every startup, every researcher reaches for.
それがデフォルトであり、すべての研究所、すべてのスタートアップ、すべての研究者が手に取るものである。
SpaceX looked at all of it and said no.
SpaceXはそのすべてを見て、ノーと言った。
彼らは純粋なC言語で独自のトレーニングスタックを記述したのだ。
Why does that matter? Python carries real overhead.
なぜそれが重要なのか。 Pythonには現実的な諸経費がある。
The GIL means Python executes one thread at a time.
GIL(グローバルインタプリタロック)があるため、Pythonは一度に1つのスレッドしか実行しない。
すべての演算呼び出しにおいてインタプリタの遅延が発生する。
At the scale SpaceX is operating, those aren’t rounding errors — they’re real bottlenecks.
SpaceXが稼働させている規模では、それらは誤差ではなく、実際のボトルネックとなる。
C++ has its own tax — vtable lookups, template instantiation, exception handling infrastructure.
C++にも独自の代償がある——vテーブルのルックアップ、テンプレートのインスタンス化、例外処理のインフラなどだ。
C++ gives you abstractions and abstractions always cost something.
C++は抽象化をもたらし、抽象化には常にコストが伴う。
At 220,000 GPUs running in tight coordination, cost compounds fast.
22万基のGPUが密に連携して稼働している状況では、そのコストは急速に膨れ上がる。
Pure C gives you full control.
純粋なC言語は、完全な制御を可能にする。
Memory layout, cache line alignment, prefetch hints — you decide everything.
メモリレイアウト、キャッシュラインの整列、プリフェッチのヒントなど、すべてを自分で決定できる。
Nothing is autotuned by a compiler that doesn’t know your topology.
あなたのトポロジーを理解していないコンパイラによって自動チューニングされるものなど何もない。
This is the difference between writing software like an ML engineer and writing software like a kernel engineer.
これは、機械学習エンジニアのようにソフトウェアを書くことと、カーネルエンジニアのようにソフトウェアを書くことの違いである。
SpaceX chose the kernel engineer path.
SpaceXはカーネルエンジニアの道を選んだのだ。
Now the “exact-maps to 220k GB300s” part — this is where it gets wild.
GB300 22万基への「完全マッピング」という部分――ここからが非常に過激である。
GB300 is NVIDIA’s Blackwell Ultra GPU. 192GB HBM3e per chip.
GB300はNVIDIAのBlackwell Ultra GPUであり、1チップあたり192GBのHBM3eを搭載している。
Massive NVLink bandwidth. The most powerful AI accelerator shipping right now.
膨大なNVLink帯域幅を持ち、現在出荷されている中で最も強力なAIアクセラレータである。
And SpaceX has 220,000 of them. For context — GPT-4 was trained on roughly 25,000 A100s.
そしてSpaceXはそれを22万基所有している。参考までに述べると、GPT-4は約2,500基のA100でトレーニングされた。
SpaceX assembled a cluster nearly 9x that GPU count, on hardware that’s dramatically more capable than the A100.
SpaceXは、A100よりも劇的に高性能なハードウェア上で、そのGPU数の約9倍に迫るクラスタを構築したのだ。
The 800G NICs are 800 Gigabit network cards — likely InfiniBand NDR — the pipes that let GPUs across different physical nodes talk to each other without becoming the bottleneck themselves.
800G NICは800ギガビットのネットワークカード(おそらくInfiniBand NDR)であり、異なる物理ノード間にあるGPU同士が、それ自体をボトルネックにすることなく通信できるようにするパイプである。
“Exact-maps” is the key phrase and most people are missing what it means.
「完全マッピング」は重要なキーワードであり、ほとんどの人はその意味を理解し損ねている。
Most frameworks schedule operations across devices abstractly.
ほとんどのフレームワークは、デバイス間の処理を抽象的にスケジュールする。
They don’t actually know your physical topology. They guess.
それらは物理的なトポロジーを実際に知っているわけではなく、推測しているのだ。
NCCL — NVIDIA’s Collective Communications Library — tries to figure out the optimal AllReduce ring topology at runtime. It’s genuinely good at this.
NVIDIAの集合通信ライブラリであるNCCLは、実行時に最適なAllReduceのリングトポロジーを見つけ出そうとする。これは本当に優れたものである。
But it can’t know things that only the hardware designer knows. SpaceX hardcoded everything.
しかし、ハードウェア設計者にしか分からないことは、知るよしもない。SpaceXはすべてをハードコードした。
Which operation runs on which GPU. Which GPU talks to which GPU over NVLink. Which nodes communicate over the 800G fabric and in what order.
どの処理がどのGPUで実行されるのか。どのGPUがNVLinkを介してどのGPUと通信するのか。どのノードが800Gファブリックを介して、どのような順番で通信するのか。
The software topology mirrors the physical hardware topology one-to-one.
ソフトウェアのトポロジーが、物理ハードウェアのトポロジーと1対1でミラーリングされているのだ。
No AllReduce surprises. No NCCL guessing. No communication overhead from a framework that doesn’t know what silicon it’s running on.
AllReduceのサプライズもなく、NCCLの推測もなく、自分がどのシリコン上で動作しているのか分からないフレームワークによる通信諸経費もない。
The pipeline parallelism emphasis makes complete sense at this scale.
この規模では、パイプライン並列化への重点的アプローチが完全に理にかなっている。
==============================
==============================
==============================

ズワイガニ 半むき身 生冷凍 1200g 1.2kg ズワイ蟹 ずわい蟹 かに 蟹 カニ 生 刺身 鍋用 しゃぶしゃぶ カニ刺し 送料無料 [TAKUMIの逸品] 価格:14,400円(税込、送料無料) (2026/1/8時点)


魚 セット さかな 切り身 詰め合わせ おにぎりの具 冷凍食品 焼き魚 食品 8種セット (約50gx16切入) 【 簡易包装(熨斗はありません)】 敬老の日 お歳暮 クリスマス お正月 ※ 訳あり 骨なし ではありません 価格:3,960円税込、送料別) (2026/1/8時点)

Titan Army|タイタンアーミー ゲーミング液晶ディスプレイ(27型/FAST IPS/WQHD 2560×1440/320Hz/1ms/HDR1000/HDMI2.1/DP1.4/PBP・PIP対応/VESA)(ブラック) P275MS+ 価格:62,800円(税込、送料別) (2025/8/1時点)


-
(2)SpaceXは、他のすべてのAI研究所をC… 2026.11.09
-
2026年、コーディングはもう死んだのか。… 2026.11.03
-
これは、AIがまだあなたを代替できない理… 2026.11.01


